我最近在算一笔账:跑一个模型到底贵在哪。算下来发现,训练一次烧钱以亿计听着吓人,但那是一次性的;真正天天在烧的是「推理」——每一次提问都在消耗 GPU。把单位成本打下来,才是 2026 年最实在的竞争力。
一、为什么推理贵
自回归模型逐 token 生成,过程中要常驻 KV Cache,并发一高显存就爆;加上大批量请求,单卡吞吐很快触顶。贵的不是「一次」,而是「每秒几万次」。
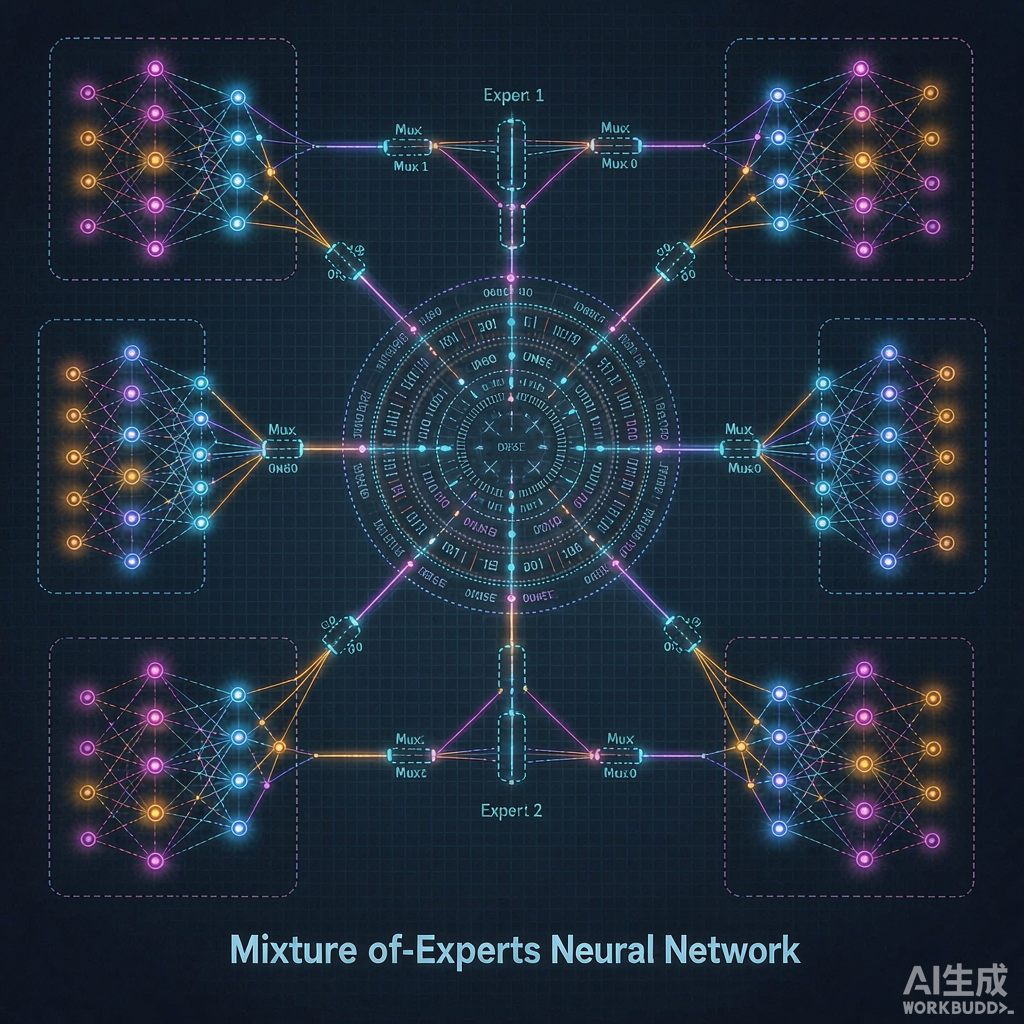
二、MoE:同样的参数,更少的算力
混合专家(Mixture-of-Experts)让模型「总参数量很大,但每次只激活一小部分专家」。算力随 token 走,推理又快又便宜。DeepSeek、Mixtral 都是这条路线的代表。
三、蒸馏与量化:把大块头压小
- 知识蒸馏:用大模型「教」小模型,小模型部署便宜、延迟低,适合边缘与批量场景。
- 量化:FP16 → INT8 / INT4,显存和带宽直接砍半到四分之一,精度损失可控;再配合 KV Cache 量化,效果更明显。
四、系统层也不能少
连续批处理(continuous batching)、PagedAttention、投机解码(speculative decoding)进一步榨干吞吐。降本从来不是单点魔法,而是模型结构 + 压缩 + 推理引擎的组合拳。
我的看法
我把这几条捋下来之后最大的收获,是搞清楚了「省算力」和「省显存」根本不是一回事,别混着算:
- MoE 省的是算力——每次只激活一部分专家,同样的参数量下 FLOPs 更低,但它不省显存,所有专家的权重都还得加载着。想跑 MoE,显存该多大还是多大。
- 量化省的是显存和带宽——FP16 到 INT8 / INT4,权重体积直接砍半到四分之一,很多情况下瓶颈其实在带宽而不是算力,所以提速也很明显。
所以选型的时候得先问一句:我到底卡在哪。卡在显存不够,上 MoE 没用,得量化或者想办法 offload;卡在吞吐上不去,MoE 和连续批处理才是对症的。
另外提醒一句:量化不是免费的。INT4 在大多数任务上损失可控,但碰到长文本、数学推理这类对精度敏感的活,掉点是能感觉到的。我的做法是先量化、再跑一遍自己常用的任务对比,别只看公开榜单上的平均分。